


DeepSeek представила DeepSeek V4.1 Flash и сделала доступными веса модели на Hugging Face. Она обрабатывает как текст, так и изображения, предоставляет текстовые ответы и поддерживает контекст до 1 млн токенов.
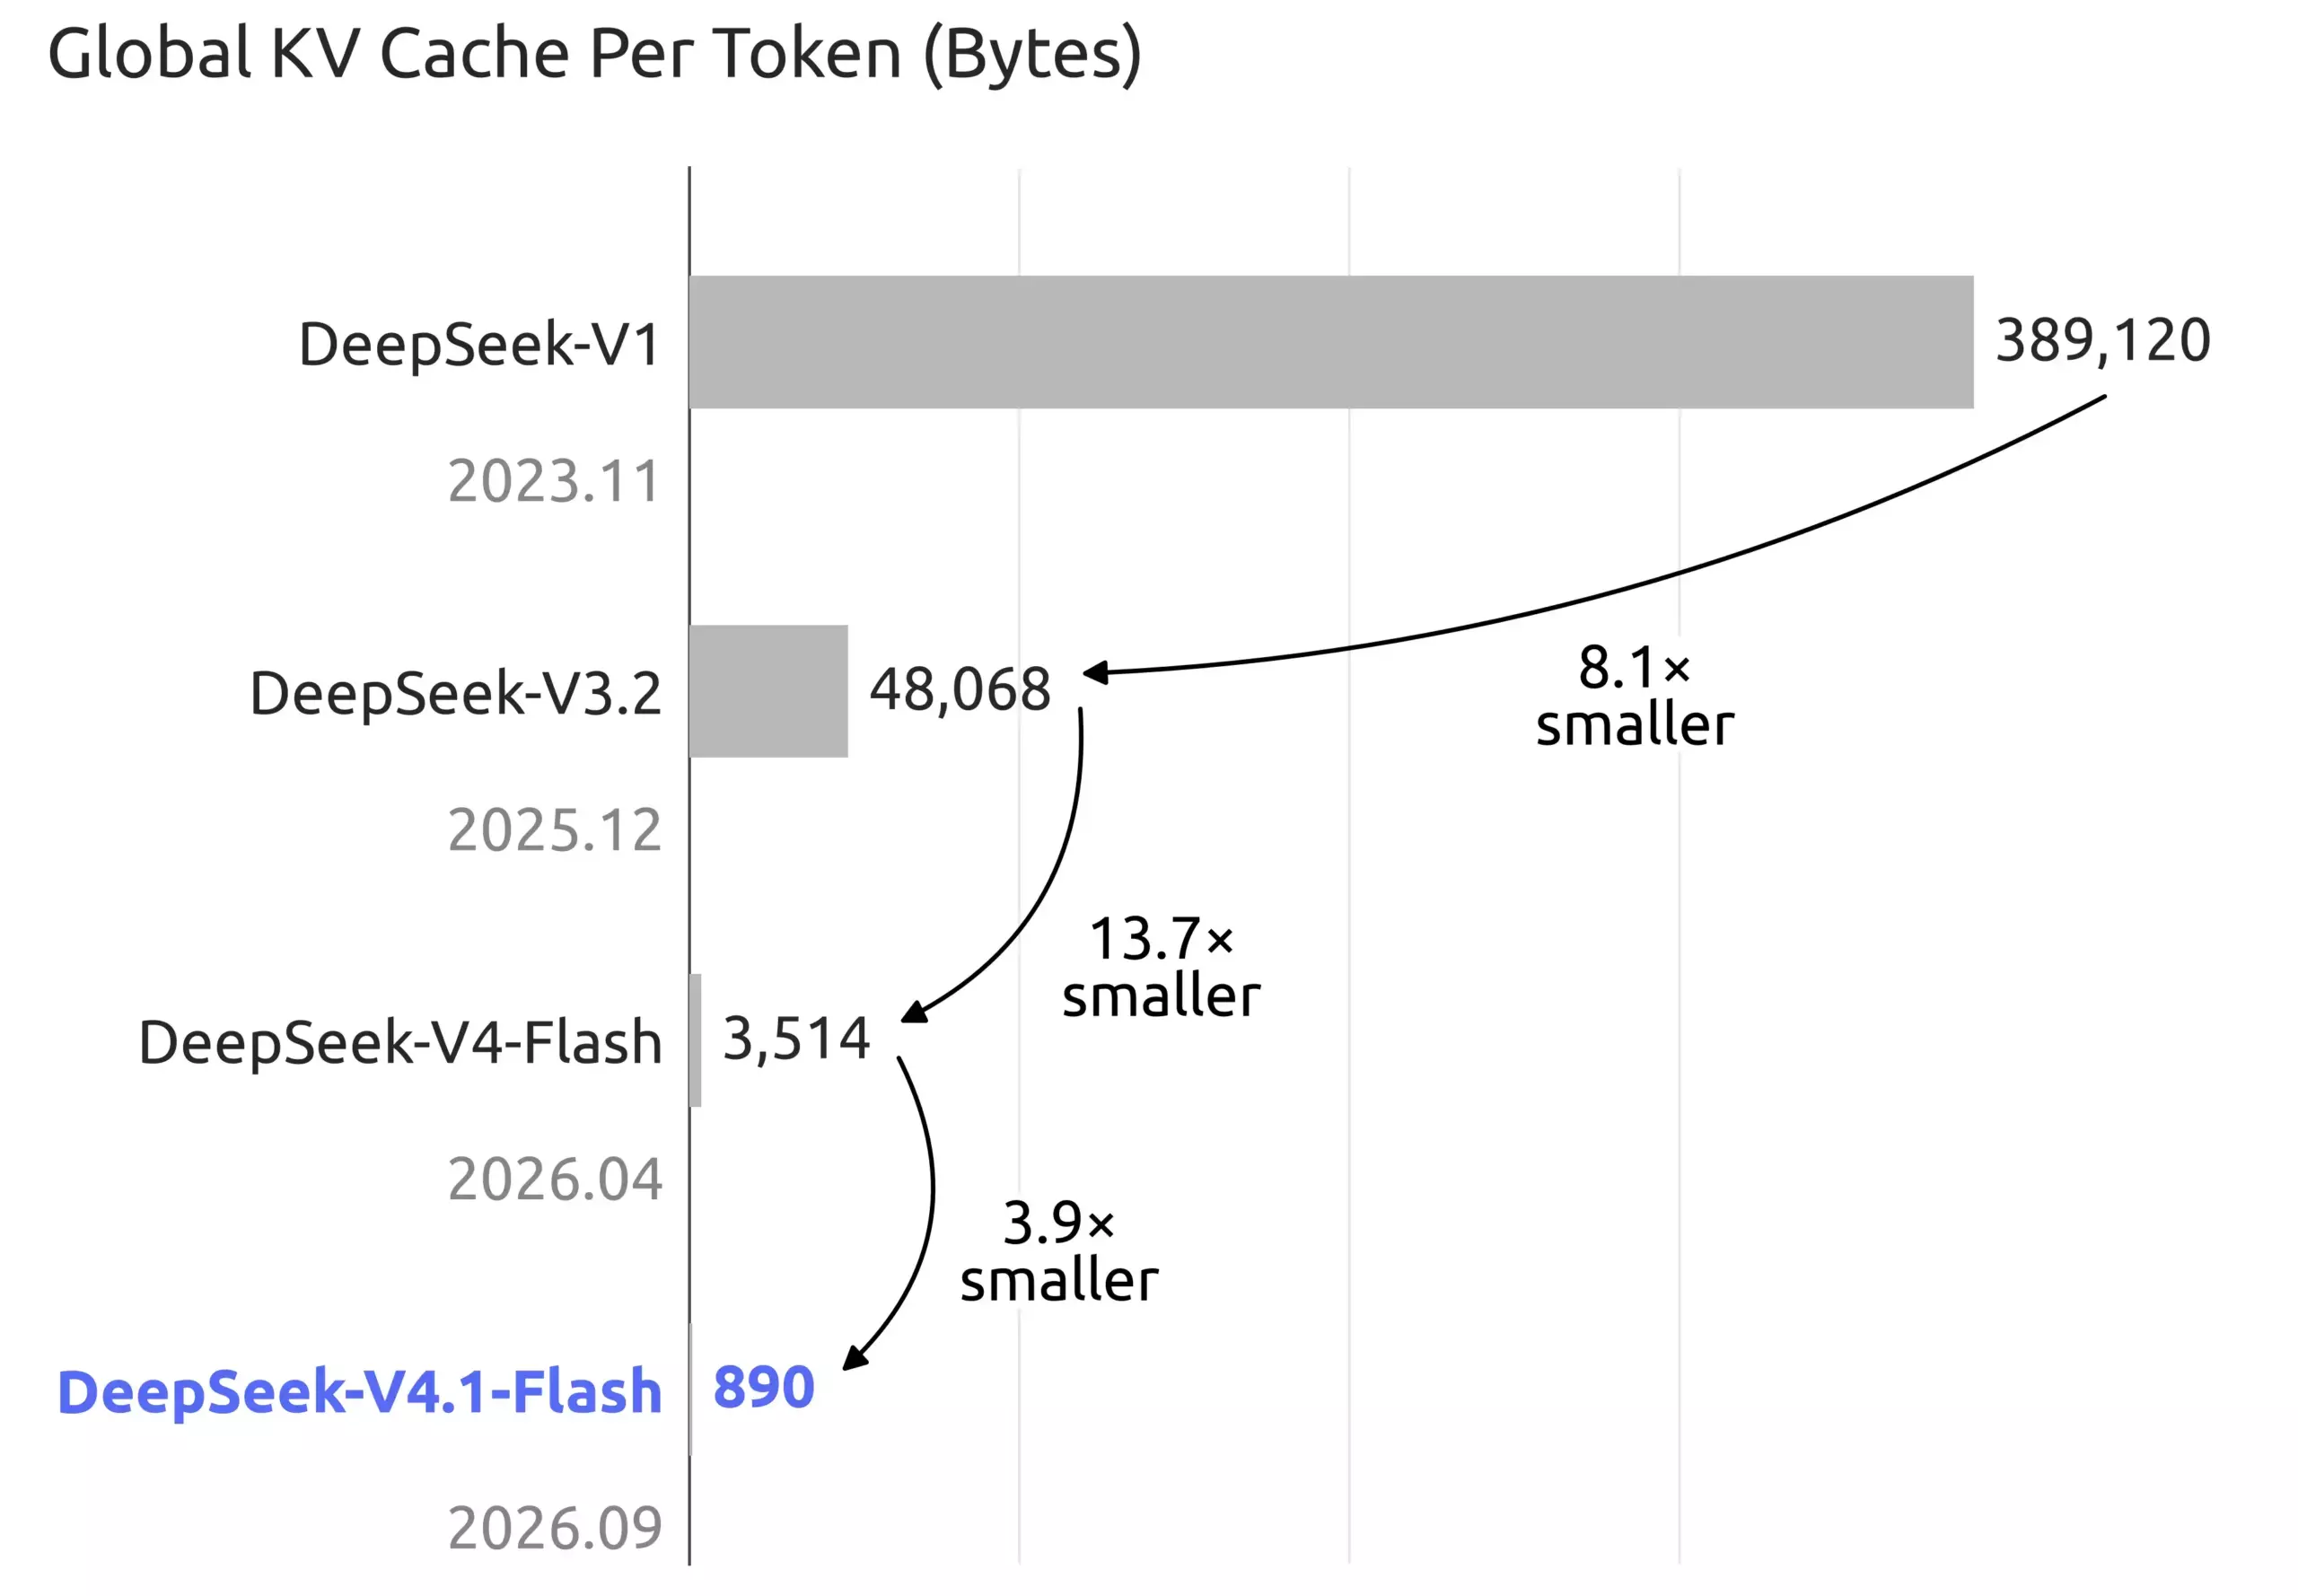
Основное отличие от DeepSeek V4 Flash заключается в новой архитектуре и более эффективной памяти для обработки длинных запросов. Глобальный KV-кэш занимает 890 байт на токен — примерно в четыре раза меньше, чем в предыдущей версии Flash.
Читайте также: Тестиум: ChatGPT или DeepSeek — кто лучше справляется с написанием текстов?
Нейросеть DeepSeek V4.1 Flash: возможности и принцип работы
Модель основывается на 552 млрд параметров. В дополнение к этому архитектура использует 196 млрд параметров Engram — специальный механизм памяти, который обращается к данным разреженно. При обработке входных данных модель задействует 8 млрд параметров на токен, а для генерации ответа — 16 млрд. Такой подход позволяет сократить вычислительные затраты: модель не задействует всю сеть для каждого отдельного элемента запроса.
Архитектура состоит из 40 слоёв: 20-слойного causal encoder и 20-слойного decoder. Декодер получает уже обработанные состояния от энкодера и не формирует отдельный полный кэш на каждом уровне. Дополнительное сжатие и повторное использование данных уменьшают потребление памяти при работе с большими документами и длинными последовательностями действий.
С помощью DeepSeek V4.1 Flash можно передавать текст и изображения в одном запросе, включая их чередование в рамках диалога. Модель анализирует визуальные и текстовые данные одновременно, однако выдаёт только текстовые ответы.
Разработчики внедрили числовую настройку глубины рассуждений в диапазоне от 1 до 100. Более высокое значение означает большее количество вычислений, затрачиваемых на формирование ответа. Этот параметр позволяет индивидуально настраивать как быстрые запросы, так и сложные задачи с инструментами.
Результаты тестирования DeepSeek на бенчмарках
DeepSeek проводила тестирование модели с максимальной глубиной рассуждений (reasoning_effort=100) и контекстом до 1 млн токенов. В DeepSWE v1.1 модель достигла 74,2% успешных решений задач, в то время как DeepSeek V4 Flash показала 54,4%. В Terminal-Bench 2.1 результаты улучшились с 82,7% до 90,6%.
Компания также сравнила различные оболочки для программирующих агентов. В DeepSWE v1.1 модель показала лучший результат — 74,2% с mini-SWE-agent (что выше, чем у Claude Opus 5 и GPT-5.6 Sol), а в Terminal-Bench 2.1 — 90,6% с минимальной оболочкой DeepSeek Harness.

Как получить доступ
Весы DeepSeek V4.1 Flash и код для самостоятельного запуска доступны на странице модели на Hugging Face. Репозиторий распространяется по лицензии MIT. Для запуска предоставлены инструкции для Transformers, vLLM, SGLang и Docker. Модель также может быть использована через API DeepSeek.
Ранее сообщалось, что DeepSeek улучшила V4-Pro — теперь она имеет контекстное окно на 1 млн токенов, максимальный объём ответа до 384 тыс. токенов и управление глубиной рассуждений через API.
Источник / изображения: huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash


